Quando o dado muda, a realidade mudou?

Coluna

Análise De Dados

30 de setembro de 2026

Quando o dado muda, a realidade mudou?

Análise de quase 20 milhões de vínculos-ano docentes entre 2020 e 2025 mostra como mudanças na composição da população e na produção dos registros podem alterar a interpretação de série histórica
Entre 2020 e 2025, o número de vínculos formais de trabalho docente identificados na RAIS (Relação Anual de Informações Sociais), do Ministério do Trabalho, passou de cerca de 2,58 milhões para 4,03 milhões. No mesmo período, houve uma transformação expressiva na composição desses vínculos: os estatutários, que eram 63,1% do total em 2020, passaram a 40,2% em 2025, enquanto os vínculos públicos não efetivos ou temporários subiram de 16,8% para 43,8%.

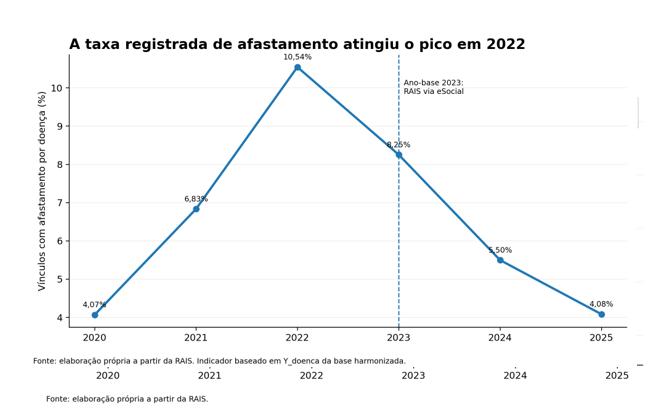
Os dados sobre afastamento por doença também chamam a atenção. A proporção de vínculos com registro de licença passou de 4,07% em 2020 para 10,54% em 2022 e, depois, recuou até praticamente retornar ao ponto inicial: 4,08% em 2025.

À primeira vista, seria tentador concluir que, depois de uma forte elevação até 2022, houve uma melhora expressiva nos anos seguintes. Quando os dados são examinados por tipo de vínculo, porém, surge um resultado difícil de ignorar. Entre os vínculos públicos não efetivos ou temporários, a taxa registrada passa de 8,47% em 2022 para apenas 0,41% em 2025.

O que aconteceu? Houve realmente uma redução dessa magnitude nos afastamentos ou mudou a forma como esse fenômeno passou a ser registrado? Essa pergunta ilustra um problema central da análise de dados: nem toda mudança observada em uma série histórica representa necessariamente uma mudança equivalente no fenômeno que pretendemos medir. Antes de interpretar um resultado, é preciso compreender como os dados foram produzidos.

Por trás dos números

Os resultados foram obtidos a partir dos microdados da RAIS, considerando cinco famílias ocupacionais relacionadas à docência. A análise abrange todos os estados brasileiros e acompanha as características dos vínculos formais de trabalho, como ocupação, idade, sexo, tipo de vínculo e registros de afastamento por doença.
Há uma distinção importante: a unidade analisada não é necessariamente uma pessoa, mas um vínculo de trabalho. Um mesmo professor pode manter mais de um vínculo e, portanto, aparecer mais de uma vez na base. Por essa razão, 4,03 milhões de registros em 2025 não significam 4,03 milhões de professores, mas aproximadamente 4,03 milhões de vínculos docentes.

Essa diferença parece apenas técnica, mas é essencial. Bases administrativas são produzidas originalmente para finalidades de registro e gestão. Quando são utilizadas para análise de dados, é necessário compreender o significado de cada variável e, principalmente, aquilo que cada registro representa.

Transformação na estrutura

Entre 2020 e 2025, o número de vínculos docentes considerados na análise aumentou aproximadamente 56%, passando de 2,58 milhões para 4,03 milhões. Mais importante do que o crescimento absoluto, porém, é observar como a composição desses vínculos se modificou. Em 2020, os vínculos públicos estatutários correspondiam a 63,1% dos registros analisados, enquanto os públicos não efetivos ou temporários representavam 16,8%. Em 2025, os percentuais passaram para 40,2% e 43,8%, respectivamente.

Se esses números fossem observados isoladamente, seria possível interpretar o período como evidência de uma rápida transformação na estrutura do trabalho docente. Mas justamente nesse intervalo ocorreu uma mudança importante na própria produção da RAIS.

Fonte dos dados

A partir do ano-base de 2023, o cumprimento da RAIS passou a ser aferido unicamente pela extração dos eventos informados no eSocial para todos os grupos de declarantes, incluindo os órgãos públicos. A Nota Técnica da RAIS 2023 registra uma importante quebra na série histórica e recomenda que os resultados daquele ano não sejam comparados diretamente com anos anteriores, devido ao processo de transição da forma de captação dos dados.

Isso não significa que os dados posteriores sejam inválidos nem que toda mudança observada decorra do eSocial. Significa que a comparação exige cautela. Em vez de perguntar apenas por que os números mudaram, é necessário perguntar quanto dessa mudança pertence ao fenômeno estudado e quanto pode estar relacionado à maneira como ele passou a ser registrado.

Dados de afastamento

Em 2020, 4,07% dos vínculos analisados apresentavam registro de afastamento. A taxa sobe para 6,83% em 2021 e alcança 10,54% em 2022, o maior valor da série. Depois disso, recua para 8,25% em 2023, 5,50% em 2024 e 4,08% em 2025. Há duas tentações nessa leitura. A primeira seria associar automaticamente o pico de 2022 aos efeitos da pandemia. A segunda seria interpretar a queda posterior como evidência de melhora nas condições de saúde dos professores. Os dados utilizados aqui, isoladamente, não permitem sustentar nenhuma dessas conclusões causais. O que se pode afirmar é mais restrito: o indicador de afastamento registrado na base aumentou fortemente até 2022 e caiu nos três anos seguintes.
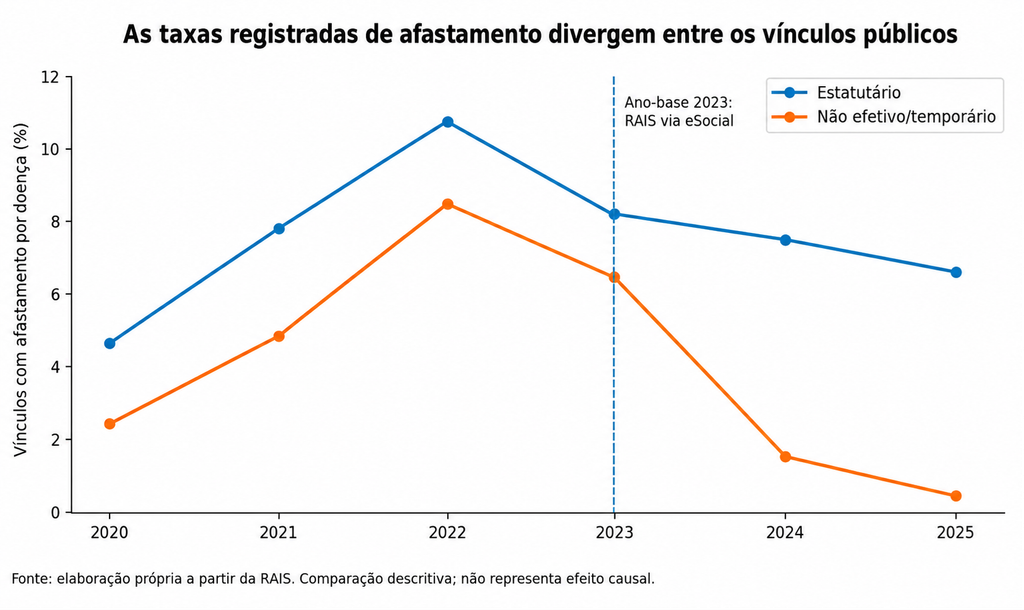
Entre os vínculos públicos estatutários, a taxa registrada de afastamento passou de 4,63% em 2020 para 10,68% em 2022. Em seguida, recuou para 8,19% em 2023, 7,55% em 2024 e 6,59% em 2025. Entre os vínculos públicos não efetivos ou temporários, a trajetória é muito mais acentuada: 2,44% em 2020, 8,47% em 2022, 6,47% em 2023, 1,53% em 2024 e apenas 0,41% em 2025.

Uma redução de 8,47% para 0,41% poderia produzir uma manchete atraente. Mas não sabemos, a partir desses números, se professores com vínculos não efetivos passaram a adoecer menos. O que sabemos é que a frequência com que o afastamento aparece registrado nesses vínculos caiu drasticamente. A diferença é fundamental.

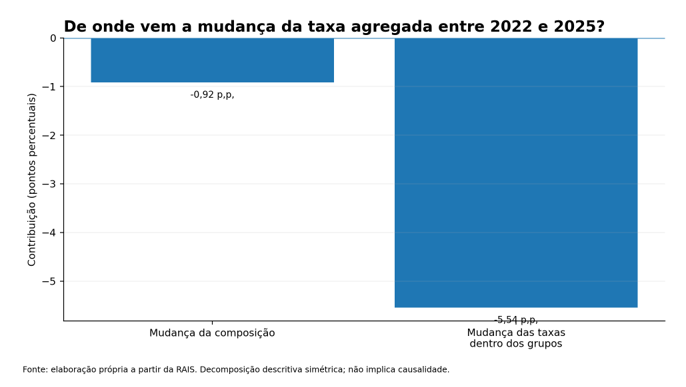
Para investigar se a queda da taxa geral poderia ser explicada simplesmente pela mudança na composição dos vínculos, a variação entre 2022 e 2025 foi decomposta em duas parcelas: uma associada à alteração da participação dos diferentes tipos de vínculo e outra relacionada às mudanças das taxas registradas dentro desses grupos.

A taxa agregada caiu de 10,54% para 4,08%, redução de 6,46 pontos percentuais. Desse total, aproximadamente 0,92 ponto percentual está associado à mudança da composição dos vínculos, enquanto 5,54 pontos percentuais decorrem das mudanças das taxas registradas dentro dos grupos. Em termos proporcionais, cerca de 14% da redução está associada à composição, e aproximadamente 86%, às mudanças intragrupo.

Matematicamente, a decomposição mostra que a queda agregada não ocorreu apenas porque aumentou a participação de determinado tipo de vínculo. Mas uma técnica estatística pode decompor corretamente aquilo que está registrado na base e, ainda assim, não resolver um problema de mensuração. Se a forma de produzir os dados mudou durante o período, a decomposição também refletirá essa mudança.
Em 2020, a taxa agregada de afastamento era de 4,07%. Em 2025, era de 4,08%. Observando apenas os dois extremos, praticamente nada parece ter mudado. A decomposição conta outra história: a alteração na composição dos vínculos contribuiu com aproximadamente -1,15 ponto percentual para a taxa, enquanto as mudanças das taxas internas contribuíram no sentido contrário, com aproximadamente +1,16 ponto percentual. Os dois movimentos praticamente se anularam.

Assim, 4,07% e 4,08% são números quase idênticos produzidos por estruturas bastante diferentes. Indicadores agregados são úteis, mas podem esconder transformações importantes na população analisada.

O que esse caso ensina

O caso da RAIS mostra que uma análise de dados não começa no algoritmo. Ela começa na compreensão da base. Poderíamos ter observado a queda entre 2022 e 2025, aplicado técnicas estatísticas e encerrado a análise com uma conclusão aparentemente consistente. Os cálculos estariam corretos. O problema estaria na interpretação.

Esse problema não é exclusivo da RAIS. Uma nova regra de preenchimento, a migração de um sistema, uma alteração de classificação, a inclusão de novos usuários ou uma mudança na obrigatoriedade de determinado campo pode criar uma quebra que, em um gráfico, se parece perfeitamente com uma mudança de comportamento.

Por isso, algumas perguntas deveriam anteceder qualquer modelo mais sofisticado: a população observada permaneceu comparável? As definições das variáveis continuaram as mesmas? A cobertura mudou? Houve alteração no sistema que produz os registros?

Mais dados também não significam necessariamente mais informação. Com milhões de vínculos, diferenças pequenas podem ser calculadas com enorme precisão. Mas precisão numérica e validade da interpretação são coisas diferentes. Se uma variável passa a ser registrada de maneira diferente, milhões de registros podem reproduzir essa diferença com enorme consistência. Antes de perguntar “qual modelo devo utilizar?”, muitas vezes a pergunta mais importante é “o que exatamente este dado está medindo?”.

O valor de um resultado inesperado

O resultado de 0,41% poderia ter sido tratado como uma descoberta. Em vez disso, ele funcionou como um alerta. Resultados muito diferentes do esperado não precisam ser descartados, mas também não deveriam ser imediatamente transformados em conclusões. Eles podem indicar um fenômeno relevante, um erro de processamento, uma mudança de população, uma alteração metodológica ou uma característica da fonte que ainda não compreendemos.

Nesse caso, a análise começou como uma exploração de milhões de vínculos docentes e terminou revelando algo mais amplo sobre o próprio trabalho com dados: às vezes, a principal descoberta não está no número encontrado, mas na razão pela qual ele deve ser examinado com cautela.

A RAIS permite enxergar transformações importantes no mercado formal de trabalho brasileiro e oferece uma riqueza de informações difícil de reproduzir por outras fontes. A análise identificou crescimento expressivo dos vínculos docentes, mudanças relevantes em sua composição e grandes oscilações nos registros de afastamento por doença entre 2020 e 2025.

Esses resultados continuam sendo informativos. O que muda é a forma de interpretá-los. A transição para o eSocial mostra por que séries históricas não devem ser tratadas apenas como sequências de números. Cada ponto de uma série é resultado de regras, sistemas, definições e processos administrativos que também possuem uma história.

Para quem trabalha com Data Science, uma das principais conclusões deste exercício é que, antes de explicar por que um indicador mudou, deve-se verificar se o mesmo fenômeno continua sendo medido da mesma maneira.

Um algoritmo pode encontrar padrões em milhões de registros. Saber se esses padrões representam o fenômeno que queremos compreender continua sendo uma tarefa humana.

Para ter acesso às referências desse texto clique aqui

Quem publicou esta coluna

José Erasmo Silva
José Erasmo Silva é professor, formado em Matemática e Administração, com mais de 25 anos de experiência em gestão empresarial e de pessoas. É mestre e doutor em Administração, com foco em Finanças, e especialista em Data Science e Analytics e em Finanças e Controladoria. Realizou pós-doutorado na Universidade Federal da Bahia (UFBA). Atualmente, atua como professor orientador no MBA em Data Science, Inteligência Artificial e Analytics da USP/Esalq e leciona na EEP/FUMEP e na rede estadual de ensino de São Paulo.

Você também pode gostar

08 de outubro de 2026

Árvores de classificação e regressão para previsão dos resultados de deputados estaduais em São Paulo

As eleições no Brasil movimentam recursos significativos, e a formação de chapas competitivas é um desafio para os partidos. Avaliou-se a viabilidade de modelos de classificação e regressão baseados em árvores de decisão e florestas aleatórias para identificar candidatos com potencial de eleição e competitividade, e para prever sua votação nominal na disputa para deputado estadual em São Paulo em 2022. A amostra incluiu todos os candidatos a deputado estadual em São Paulo em 2022, utilizando dados eleitorais, demográficos, partidários e econômicos do período entre 2018 e 2022. A seleção de hiperparâmetros foi realizada por busca em grade, seguida de análise de sensibilidade para o ponto de corte, e a pontuação F1 foi a métrica principal. Comparou-se os modelos de árvore de decisão e floresta aleatória usando F1 e AUC-ROC. O modelo de classificação de candidatos competitivos alcançou uma pontuação F1 de 0,70 e 94% de AUC-ROC, demonstrando ser uma ferramenta viável para auxiliar a tomada de decisão de partidos e candidatos. Os modelos de previsão de eleitos e de votos nominais foram considerados insuficientes. Concluiu-se que características de eleições passadas e o conceito de competitividade são preditores relevantes para a previsibilidade eleitoral, e que o uso de árvores de classificação e regressão, especialmente florestas aleatórias, é adequado para a previsibilidade da competitividade de candidatos.

Palavras-chave: Análise de sensibilidade; Competitividade eleitoral; Florestas aleatórias; Scikit-Learn.

08 de outubro de 2026

Disrupções analíticas para a governança da pesca artesanal na Amazônia: Novas abordagens para dados limitados de desembarque

Técnicas de machine learning foram propostas para a governança da pesca artesanal na Amazônia, buscando superar limitações de dados de desembarque. O estudo objetivou constituir grupos de manejo, avaliar tendências temporais e propor modelos de predição para dados de desembarque pesqueiro, a fim de apoiar a tomada de decisão e o ordenamento. Os dados de desembarque, coletados entre 2010 e 2022 nos rios Baixo Amazonas e Baixo Araguaia-Tocantins, foram integralizados em uma matriz de análise. Adotou-se a família taxonômica como unidade de estoque funcional para agrupar os dados. Foram empregadas técnicas multivariadas de agrupamento (clusterização hierárquica e K-means), análise e simulação de séries temporais (modelo ARIMA Forecast otimizado) e técnicas multivariadas confirmatórias (modelos de regressão em painel longitudinal). A análise de agrupamento segmentou grupos de estoques funcionais por faixas de quilos de peixe (Alvos Mistos, Alvos Baixo Araguaia-Tocantins, Alvos Baixo Amazonas). A investigação de padrões temporais revelou que o atraso de 12 meses foi a melhor alternativa, indicando que as pescarias de um ano afetam as do ano seguinte. Os modelos ARIMA-Forecast otimizados foram bem ajustados, mas não detectaram tendência de declínio ou aumento no comportamento temporal, sugerindo estratégias de adaptação da pesca artesanal. O modelo em painel indicou um quadro estratégico de priorização de estoques funcionais para monitoramento e ordenamento. As abordagens analíticas disruptivas e inovadoras desenvolvidas modernizaram os protocolos de governança da pesca artesanal na Amazônia, fornecendo um painel de indicações estratégicas para o manejo, especialmente nas regiões do Baixo Amazonas e Baixo Araguaia-Tocantins.

Palavras-chave: Amazônia; Desembarque pesqueiro; Estoques funcionais; Governança; Manejo.

08 de outubro de 2026

Transformação de Dados Transacionais em Inteligência de Negócio: Framework de “Data Wrangling” e “Dashboards”

A evolução das capacidades de captura e processamento de dados tornou imperativa a transformação de informações para tomada de decisão ágil e bem-informada. O estudo focou na aplicação de conhecimentos da ciência de dados para capturar, processar e manipular dados transacionais de um comércio britânico, visando facilitar a compreensão e a tomada de decisões sobre consumidores, produtos e vendas. Utilizou-se uma abordagem qualitativa do tipo pesquisa-ação, empregando dados transacionais de um varejo digital do Reino Unido. Os dados foram tratados em Python, aplicando técnicas de data wrangling, modelagem dimensional em esquema estrela e métodos estatísticos como Tuckey Fences (IQR) para normalização de preços. A segmentação de consumidores foi realizada por meio do algoritmo K-Means, considerando frequência e valor monetário. Os dados processados foram então carregados e visualizados em dashboards interativos no Power BI. Os resultados revelaram a identificação de diferentes perfis de consumidores, destacando a importância de clientes de alto valor e a oportunidade de crescimento em mercados específicos. Observaram-se tendências de vendas sazonais e anomalias em dados de produtos, evidenciando a necessidade de governança de dados. Concluiu-se que o framework desenvolvido permite transformar dados brutos em diagnósticos estratégicos, promovendo a maturidade digital e a tomada de decisão baseada em dados.

Palavras-chave: Clustering; Dashboards; Data Wrangling; Power BI.

08 de outubro de 2026

Precificação dinâmica de estúdios por temporada com algoritmos “multi-armed bandits”

As plataformas digitais de hospedagem transformaram o mercado de aluguel por temporada na última década, tornando a precificação um determinante crucial do desempenho econômico dos imóveis. Investigou-se como algoritmos da classe “Multi-Armed Bandits” (MAB) podem otimizar essa decisão de preço, comparando-se as estratégias ε-Greedy, Upper Confidence Bound (UCB) e Thompson Sampling (TS). A base analítica reuniu 2.284 observações de 571 estúdios no Rio de Janeiro, coletadas entre junho de 2024 e março de 2025. A qualidade percebida dos imóveis foi sintetizada por Análise de Componentes Principais (PCA), e a demanda modelada por regressão linear ordinária (OLS) com sete variáveis significativas. O modelo explicou 10% da variação na ocupação. Simulações foram realizadas em 1.000 rodadas e 50 repetições estocásticas em cenários estacionário e dinâmico multi-estação. No cenário estacionário, o UCB maximizou a receita acumulada, seguido por ε-Greedy e TS. No cenário dinâmico multi-estação, o UCB manteve a receita absoluta mais alta, mas o TS apresentou queda relativa menor entre cenários, indicando maior adaptabilidade à volatilidade sazonal. Concluiu-se que, em mercados oscilantes, a adaptabilidade bayesiana do TS compensou seu custo de exploração, tornando-o mais robusto a mudanças de contexto.

Palavras-chave: Aprendizado por reforço; Decisão sequencial sob incerteza; Hospedagem de curta duração; Otimização de receita; Sazonalidade turística.

08 de outubro de 2026

Otimização do processo de gaseificação de biomassa para produção de hidrogênio usando redes neurais agregadas

A matriz mundial de produção de hidrogênio ainda é dependente em 98% de fontes fósseis, gerando um passivo ambiental de aproximadamente 9 kg de CO2 para cada kg de H2 produzido. No cenário brasileiro, a gaseificação do bagaço de cana-de-açúcar surge como uma alternativa de baixo carbono, porém a complexidade e a não-linearidade das reações termoquímicas dificultam o controle e a maximização do rendimento por métodos convencionais. O estudo objetivou identificar parâmetros operacionais ótimos para a gaseificação de biomassa, visando maximizar a fração molar de hidrogênio, por meio de uma abordagem computacional integrada que combinou simulação termodinâmica e técnicas de inteligência artificial. Para tal, o processo de gaseificação foi simulado no software Aspen Plus e, após validação com dados da literatura, gerou uma base de dados de 1.000 cenários por amostragem via hipercubo latino. Esses dados alimentaram um metamodelo de redes neurais agregadas por bootstrap (BANN) com 57 neurônios, seguido da aplicação do algoritmo de otimização por enxame de partículas (PSO) para a busca do ótimo global. O metamodelo alcançou um coeficiente de determinação R² de 0,9902 no conjunto de teste, indicando elevada capacidade preditiva. A otimização revelou que a fração molar de hidrogênio pode atingir 67,54% após enriquecido por meio da reação de deslocamento do gás de água (WGS) sob condições de 857,12 °C e razão de equivalência (ER) de 0,10. A integração BANN-PSO reduziu o custo computacional da otimização em aproximadamente 5.400 vezes em relação à simulação direta no Aspen Plus, identificando condições operacionais que maximizam a fração molar de hidrogênio para 67,54% na entrada da PSA. Ao integrar modelagem termodinâmica, aprendizado de máquina, otimização metaheurística e técnicas de interpretabilidade, o estudo contribuiu para o avanço metodológico na análise e intensificação de processos de produção de hidrogênio a partir de biomassa, oferecendo uma estrutura computacional reprodutível e aplicável a sistemas energéticos complexos no contexto da transição energética.

Palavras-chave: Aprendizado de máquina; Bagaço de cana; Gás de síntese; Meta-heurística; Sustentabilidade.

08 de outubro de 2026

Ferramentas de gestão do tempo em uma instituição bancária na cidade de São Paulo

A gestão do tempo constitui-se como um diferencial competitivo estratégico, especialmente no setor bancário, ambiente caracterizado por alta pressão e constante transformação tecnológica. O estudo teve como objetivo analisar as percepções dos colaboradores de uma instituição bancária na cidade de São Paulo acerca da eficácia e aplicabilidade das ferramentas de gestão do tempo em suas rotinas profissionais. Para isso, adotou-se uma metodologia de pesquisa descritiva, de abordagem quantitativa, operacionalizada por meio de um levantamento (survey) que envolveu 37 colaboradores, os quais responderam a um questionário estruturado de 14 questões. Os resultados revelaram que, embora 45,9% dos respondentes planejassem a maior parte de suas atividades, a técnica predominante utilizada foi a de listas de tarefas simples (64,9%), com baixa adesão a métodos mais estruturados. Os maiores obstáculos identificados para a gestão eficaz do tempo foram as interrupções não planejadas (43,2%) e o excesso de reuniões improdutivas. Um dado crítico apontou que a gestão ineficiente do tempo impactou diretamente a saúde mental e o estresse de 48,6% da amostra. Concluiu-se que a eficácia da gestão do tempo no ambiente bancário depende não apenas da adoção de ferramentas individuais, mas também de uma mudança na cultura organizacional que privilegie o trabalho focado e a redução da fragmentação das atividades. Recomendaram-se a implementação de práticas como o Time Blocking e a adoção de protocolos de reuniões mais objetivos para mitigar a sobrecarga e promover o bem-estar sustentável.

Palavras-chave: Bem-estar ocupacional; Cultura organizacional; Eficiência operacional; Metodologias ágeis; Produtividade.

Neurociência E Aprendizagem Na Educação

08 de outubro de 2026

Consequências do Uso de IA Generativa na Capacidade Cognitiva e Saúde Mental de Profissionais Brasileiros

A integração de ferramentas de inteligência artificial generativa (GenAI) no trabalho acelerou-se nos últimos anos, levantando questões sobre seus efeitos nos processos cognitivos e no bem-estar emocional dos profissionais. O estudo objetivou mensurar o impacto do uso de GenAI sobre capacidades cognitivas autorreferidas e indicadores de saúde mental de profissionais brasileiros, comparando os achados com evidências empíricas internacionais. Adotou-se uma abordagem mista, com delineamento transversal e não experimental, aplicando um questionário digital estruturado a 108 profissionais adultos brasileiros, recrutados via LinkedIn e WhatsApp. O instrumento avaliou memória de trabalho, atenção sustentada e alternada, controle inibitório, flexibilidade cognitiva, tecnoestresse, saúde mental e senso de propósito profissional, além de percepções qualitativas. Os resultados revelaram que 92,6% dos respondentes utilizaram GenAI regularmente, com impacto percebido majoritariamente positivo no desempenho, mas acompanhado por dependência declarada em 52,8% da amostra. A atenção sustentada mostrou-se a dimensão cognitiva mais fragilizada, e os indicadores de equilíbrio emocional e desconexão digital concentraram os resultados mais críticos. A análise comparativa identificou uma relação entre maior frequência de uso, maior dependência e menores escores cognitivos, com declínio progressivo da atenção focada ao longo do tempo de uso. Concluiu-se que o uso intensivo de GenAI coexiste com fragilidades cognitivas e emocionais mensuráveis, cujos efeitos tendem a se acumular, reforçando a necessidade de práticas conscientes que preservem a autonomia intelectual dos profissionais.

Palavras-chave: Cognição; Dependência tecnológica; Inteligência artificial; Saúde mental.

Neurociência E Aprendizagem Na Educação

08 de outubro de 2026

A contribuição da neuroaprendizagem na elaboração de objetos educacionais multimídia para a recomposição de aprendizagens

A defasagem de aprendizagem na educação brasileira, agravada pela pandemia de Covid-19 e evidenciada por resultados insatisfatórios do SAEB, tornou a recomposição de aprendizagens uma prioridade nacional. O presente trabalho analisou como a produção audiovisual, integrante de um programa de recomposição de aprendizagens em Língua Portuguesa e Matemática, desenvolvido para estudantes do 9º ano do Ensino Fundamental de uma rede estadual, incorporou fundamentos da neurociência da aprendizagem em sua estrutura metodológica. A pesquisa caracterizou-se como estudo de caso qualitativo e aplicado, e analisou 20 roteiros pedagógicos e as respectivas videoaulas produzidas e aplicadas em 2024. A partir do referencial teórico, construíram-se sete dimensões de análise: ludicidade e interatividade, funcionamento cerebral e aprendizagem, emoção e cognição, singularidade do estudante, contexto sociocultural, mediação pedagógica consistente e aprendizagem ativa. Os resultados indicaram que elementos da neuroaprendizagem foram incorporados de forma estrutural à metodologia do programa. Identificou-se que a personalização da aprendizagem não reside exclusivamente no objeto audiovisual, mas na cadeia sistêmica que o envolve, incluindo diagnóstico, produção, mediação presencial e monitoramento. A integração entre neurociência, conteúdos dedicados à superação de lacunas e linguagem audiovisual demonstrou ser uma estratégia metodologicamente consistente e com potencial relevante para ampliar a eficácia de programas de recomposição de aprendizagens.

Palavras-chave: Defasagem; Eduentretenimento; Mediação pedagógica; Plasticidade cerebral; Videoaula.

Gestão Escolar

08 de outubro de 2026

Lei do Novo Ensino Médio: monitoramento e avaliação da qualidade após a reforma

A qualidade do Ensino Médio no Brasil tem sido objeto de debates diante das mudanças iniciadas pela Lei nº 13.415/2017 e reestruturadas pela Lei nº 14.945/2024. Analisou-se a evolução de indicadores associados à qualidade do Ensino Médio entre 2017 e 2024, considerando aprendizagem, fluxo, permanência e equidade, e discutiram-se as implicações dos mecanismos federais de monitoramento para a gestão escolar. Realizou-se estudo exploratório e descritivo, de abordagem quantitativa e natureza documental, com dados secundários do Inep sistematizados pela plataforma QEdu e documentos oficiais do Ministério da Educação. Examinaram-se taxas de aprovação, reprovação e abandono, distorção idade-série, aprendizagem adequada no Saeb e desigualdades por rede de ensino, nível socioeconômico e unidade federativa. Os resultados mostraram melhora do fluxo e redução da distorção idade-série, mas permanência de baixos níveis de aprendizagem e desigualdades expressivas. A análise documental indicou maior estruturação da governança e do monitoramento da política, ainda sem avaliação consolidada de seus efeitos sobre a aprendizagem. Para a gestão escolar, os achados orientaram o acompanhamento da transição para a 1ª série, a identificação de riscos de abandono, a recomposição das aprendizagens e a priorização de grupos mais vulneráveis. Concluiu-se que a qualidade exige a leitura articulada de indicadores e decisões contextualizadas, sem atribuir exclusivamente ao Novo Ensino Médio relações causais que o desenho desta pesquisa não permite estabelecer.

Palavras-chave: Aprendizagem; Equidade educacional; Gestão escolar; Permanência escolar; Política educacional.

Inscreva-se em nossa newsletter!

Receba conteúdos e fique sempre atualizado sobre as novidades em gestão, liderança e carreira com a Revista E&S.

Ao preencher o formulário você está ciente de que podemos enviar comunicações e conteúdos da Revista E&S. Confira nossa Política de Privacidade