13 de outubro de 2026
Delineo: Adaptação de modelo de difusão para prototipagem de interface de usuário guiada por esboço
Matheus Mendes Silva; Edilson José Rodrigues
DOI: 10.22167/2675-6528-202603291
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A evolução da inteligência artificial e das redes neurais profundas revolucionou as interações humano-máquina, mas a prototipagem de interfaces de usuário com modelos generativos enfrenta desafios críticos na preservação da estrutura espacial idealizada. Para solucionar essa divergência, adaptou-se um modelo de difusão latente condicionada, integrando uma arquitetura de controle a um modelo de larga escala ajustado especificamente para interfaces móveis. A abordagem utilizou esboços de interfaces de usuário para guiar a inferência das imagens. A viabilidade do método foi validada por meio de avaliação quantitativa automatizada e análise qualitativa conduzida com um grupo de especialistas da indústria. Os resultados confirmaram que o método superou as capacidades do modelo original, mas a avaliação evidenciou degradação estética e perda de elementos funcionais na estruturação lógica da interface. Concluiu-se que, embora a tecnologia demonstre viabilidade técnica para otimizar a transição entre requisitos e a implementação de código, a automatização de processos criativos ainda demanda aprimoramentos arquiteturais para atingir o rigor visual exigido pela indústria de desenvolvimento de software.
Palavras-chave: adaptação de baixo posto; aprendizado de máquina; difusão latente condicionada; redes neurais profundas.
1. Introdução
O processo de desenvolvimento de software passa por constantes mudanças, evoluindo para atender ao ritmo acelerado da indústria. Parte fundamental desse ciclo é a prototipagem de interface de usuário, que define a jornada do cliente e possibilita a validação dos requisitos antes da implementação (Al-Saqqa et al., 2020). Esta etapa apresenta grande abertura para exploração de metodologias baseadas em inteligência artificial (IA), podendo potencializar o processo criativo e o aumento da produtividade.
A indústria moderna busca desenvolver sistemas inteligentes e interativos, tanto máquina-a-máquina quanto humano-máquina, impulsionando a automação de tarefas e processos realizados por humanos (Ismail e Hassan, 2019). Acompanhando essa tendência, os investimentos globais em IA apresentaram crescimento notável, especialmente em países como Estados Unidos, China e Reino Unido. No setor corporativo, a adoção também cresce rapidamente: 78% das organizações reportaram o uso de IA, de acordo com o AI Index Report 2025 da Universidade de Stanford (HAI, 2025). Nesse contexto, diversos estudos exploram a utilização de inteligência artificial generativa (GenAI) para automatizar etapas do ciclo de desenvolvimento de software, incluindo a criação de documentação, produção de código, automação de testes, e até mesmo a criação de agentes para auxiliar na revisão de código e na elaboração de arquitetura de sistemas digitais (Beltramelli, 2018; He et al., 2025; Wan et al., 2025; Wang et al., 2024).
A maior parte dos estudos publicados concentra-se na produção de código, gerado a partir de especificações textuais ou imagens de interface de usuário (UI), frequentemente elaboradas por equipes dedicadas ao processo de design. Em contraste com os estudos supracitados, o presente trabalho concentra-se na etapa de concepção visual de UI. Esse processo antecede ambas as rotas de desenvolvimento, seja por codificação manual, seja por geração de código com ferramentas automatizadas, servindo como alicerce para todo o desenvolvimento de software subsequente (Lauff et al., 2018). No entanto, a aplicação dessas tecnologias para a prototipagem de interfaces de usuário, além de pouco explorada, enfrenta desafios críticos, uma vez que modelos generativos frequentemente falham em respeitar a estrutura espacial idealizada.
Modelos de redes neurais profundas são amplamente utilizados para atividades que demandam capacidade generativa. Modelos de difusão latente (LDM), uma das variantes de modelos texto-para-imagem (T2I), destacam-se por apresentar desempenho equiparável com o estado da arte e maior eficiência computacional (Rombach et al., 2022). Embora modelos T2I sejam ferramentas poderosas para geração de imagens, a entrada textual desempenha papel fundamental nos resultados obtidos, e essa arquitetura pode gerar resultados imprecisos e instáveis por não permitir maior controle do usuário nas imagens geradas, resultando em uma experiência negativa para pessoas não especializadas (Liu e Chilton, 2022; Mou et al., 2024). Considerando a natureza visual das interfaces, a automação da prototipagem de UI exige arquiteturas de redes neurais capazes de compreender e sintetizar layouts respeitando hierarquias visuais complexas. Nesse contexto, a pesquisa baseia-se em metodologias de geração condicionada de imagens, ancorando o processo de inferência em uma imagem de referência (Couairon et al., 2023; Mou et al., 2024; Zhang et al., 2023; Zhao et al., 2023).
Diante do exposto, o presente trabalho tem como objetivo adaptar modelos de difusão latente para a geração de protótipos de alta fidelidade através de treinamento suplementar, utilizando tecnologias de código aberto e bancos de dados disponibilizados publicamente. A hipótese é que os adaptadores desenvolvidos superem as capacidades do modelo base original, garantindo maior qualidade visual e fidelidade estrutural ao esboço de referência.
2. Material e Métodos
Para composição da base de dados de treinamento, foram utilizados conjuntos de dados públicos disponibilizados por trabalhos correlatos, contendo imagens de UI de aplicativos móveis. A delimitação do escopo para o ecossistema móvel visou simplificar as estruturas hierárquicas e otimizar o processo de inferência devido às dimensões menores das telas, reduzindo o custo computacional relacionado à complexidade dos cálculos matriciais.
Base de Dados
A base de dados MUD contribuiu com aproximadamente 7.200 imagens, cada uma associada a um arquivo com metadados da hierarquia de componentes, detalhando classes, coordenadas espaciais e outros atributos descritivos (Feng et al., 2024). Complementarmente, foram selecionadas aproximadamente 1.700 imagens de UI da base de dados VINS, que também disponibiliza metadados de componentes visuais e coordenadas espaciais anotadas por humanos (Bunian et al., 2021). Por fim, incorporou-se aproximadamente 3.500 imagens de esboços de UI da base SWIRE, criada em colaboração com profissionais de design (Huang et al., 2019). Cada esboço desta base faz referência às imagens de UI da base Rico (Deka et al., 2017), mas a base Rico foi evitada devido a inconsistências nos metadados espaciais (Feng et al., 2024).
Pré-processamento de dados
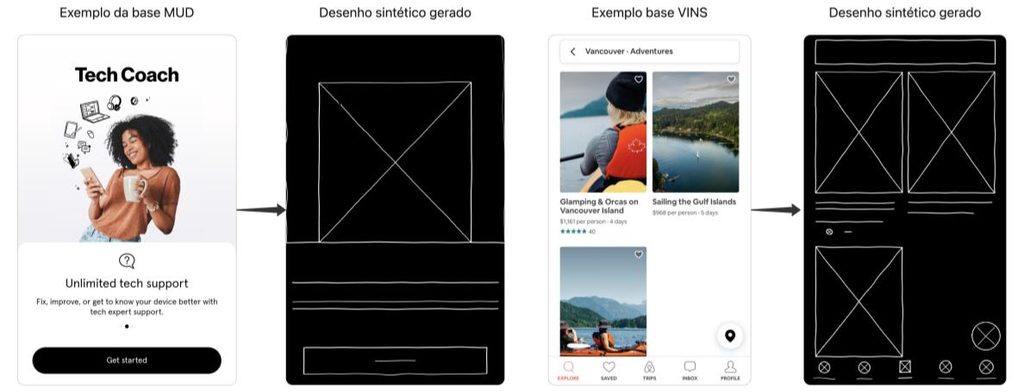
Uma etapa de pré-processamento foi implementada para garantir a consistência da base de treinamento. Inicialmente, realizou-se uma triagem dos metadados para filtrar amostras com componentes indesejados (anúncios, “iframes”), texto em alfabeto não latino, ou capturas de tela em posição horizontal. A barra de notificação presente nas imagens foi recortada para evitar ruído e vieses. Para enriquecer os dados, foram gerados dados sintéticos para criar os esboços correspondentes das bases de dados compostas unicamente por imagens de UIs. A geração das imagens foi realizada por meio de scripts desenvolvidos em Python, adaptados para a estrutura dos metadados de cada banco de dados. O algoritmo processa os metadados de hierarquia de componentes de cada UI e utiliza as informações de classe e coordenadas para desenhar a representação dos componentes relevantes utilizando a biblioteca de visão computacional OpenCV (Bradski, 2000). O resultado desse processo são imagens de fundo preto e traços brancos que mantêm a proporção de aspecto das imagens de UI originais, com pequenas distorções e ruídos aleatórios adicionados para diversidade, conforme ilustrado na Figura 1.
Figura 1. Exemplo dos resultados do pré-processamento e geração de esboço sintético
Fonte: Dados originais da pesquisa
Em seguida, todas as imagens foram redimensionadas para a resolução-alvo de 720 pixels de largura por 1280 pixels de altura, preservando a proporção original. Por fim, foram geradas as instruções textuais complementares aos esboços. As imagens foram submetidas à “application program interface” [API] do modelo multimodal “Gemini 2.0 Flash” (Google, 2025), por meio de um script desenvolvido em Python. Um “system prompt” foi elaborado para padronizar a descrição dos estilos e elementos visuais, bem como identificar e descartar amostras com ruído excessivo ou baixa qualidade estética.
Hardware, infraestrutura e ferramentas
Para o desenvolvimento dos scripts de pré-processamento, treinamento e avaliação quantitativa, adotou-se a linguagem de programação Python. A pesquisa foi fundamentada no ecossistema de software livre, utilizando bibliotecas de código aberto como Open CV (Bradski, 2000), PyTorch (Paszke et al., 2019), Diffusers (von Platen et al., 2022), Transformers (Wolf et al., 2020) e Accelerate (Gugger et al., 2020). A infraestrutura computacional consistiu em uma unidade de processamento gráfico [GPU] NVIDIA A100, equipada com 80 GB de memória de vídeo de alto desempenho, alocada por meio de serviço de computação em nuvem. Os scripts desenvolvidos encontram-se disponíveis em https://github.com/mendexjs/delineo.
Modelo de difusão base
Considerando o volume da base de dados e os recursos computacionais limitados, a estratégia adotada consistiu em um treinamento suplementar de um modelo com parâmetros congelados. O LDM “Stable Diffusion” [SD] foi escolhido como modelo base devido à sua eficiência computacional e ampla utilização em trabalhos correlatos (Rombach et al., 2022). O SD executa o processo iterativo de remoção de ruído em um espaço latente de dimensão reduzida, o que diminui o consumo de memória durante a inferência. A versão mais recente, SD 3, introduziu uma arquitetura “multimodal diffusion transformer”, que utiliza pesos distintos para o processamento das modalidades textual e visual, resultando em desempenho superior em aderência ao prompt e geração de tipografia (Esser et al., 2024). Essa arquitetura acrescenta o codificador de texto “Text-To-Text Transfer Transformer” [T5] (Raffel et al., 2020), melhorando a capacidade de compreensão de semântica e renderização de texto comparado ao CLIP (Radford et al., 2021). Testes demonstraram que o T5 melhora os resultados com instruções mais longas e detalhadas, aspecto relevante para a geração precisa de elementos de UI.
Arquitetura de controle condicionado
Para aprimorar os resultados de LDMs, Zhang et al. (2023) introduziram o “ControlNet”, uma estrutura que permite condicionar a geração de imagens através de informações espaciais adicionais. Como módulo acoplado, o “ControlNet” assegura a estabilidade do treinamento, mantendo os pesos e parâmetros originais do modelo base inalterados, delegando a estrutura espacial à rede de controle e os detalhes visuais ao modelo de difusão. O treinamento completo de uma arquitetura “ControlNet” demanda grande volume de dados e recursos computacionais. O presente estudo optou pela adaptação de uma rede “ControlNet canny edges” através de treinamento suplementar, devido à semelhança visual entre imagens de contornos e esboços de UI. Para isso, utilizou-se a base de dados de treinamento, contendo aproximadamente 12.400 imagens. A Tabela 1 apresenta as configurações e os hiperparâmetros utilizados no treinamento.
Tabela 1. Configuração de treinamento e hiperparâmetros da rede “ControlNet”
| Parâmetro / Hiperparâmetro | Valor | Descrição |
|---|---|---|
| Arquitetura do modelo | “Stable Diffusion 3.5 Large” | Modelo de difusão base |
| Arquitetura de controle | “ControlNet Canny” | Módulo de controle treinado |
| Resolução de treinamento | 1024×1024 | Resolução para redimensionamento |
| Precisão numérica | bf16 | Formato de precisão mista |
| Otimizador | 8-bit Adam | Versão quantizada do AdamW para economia de VRAM |
| Taxa de aprendizado | 10-5 | Taxa de aprendizado fixa |
| Tamanho de lote efetivo | 32 | Amostras acumuladas antes da atualização dos pesos |
| Épocas de treinamento | 18 | Passagens completas pelo conjunto de dados |
| “Gradient Checkpointing” | Ativado | Otimização de memória para treinamento em alta resolução |
Fonte: Dados originais da pesquisa
Adaptador de baixo posto
Durante os testes preliminares, observou-se que as imagens geradas não apresentavam consistência estética e variavam em qualidade visual. Para solucionar isso, foi adicionado ao “pipeline” um adaptador de baixo posto [LoRA], responsável por injetar matrizes treináveis de decomposição de baixo posto. Este tipo de adaptação é utilizado para adicionar nuances estilísticas e características específicas a modelos generativos sem necessitar de um grande volume de dados (Hu et al., 2022; Gandikota et al., 2024; Wu et al., 2024). Para o treinamento do LoRA, foram coletadas manualmente 156 imagens de UIs modernas e de categorias distintas, extraídas de repositórios gratuitos especializados em design. A geração das instruções textuais seguiu o mesmo processo e “system prompt” aplicados nas bases de treino da rede “ControlNet”. O conjunto de dados passou por um pré-processamento para padronizar o tamanho das imagens e reduzir a discrepância de representatividade das categorias com menor número de amostras, aplicando uma estratégia de sobreamostragem controlada, definindo como alvo de balanceamento o 75° percentil do volume de amostras entre as classes, com um limite estrito de quatro repetições para amostras de categorias minoritárias. A Tabela 2 apresenta as configurações e os hiperparâmetros utilizados.
Tabela 2. Configuração e hiperparâmetros para treinamento do adaptador de baixo posto
| Parâmetro / Hiperparâmetro | Valor | Descrição |
|---|---|---|
| Arquitetura do modelo | “Stable Diffusion 3.5 Large” | Modelo de difusão base |
| Rank | 64 | Posto da matriz treinável |
| Resolução de treinamento | 1024×1024 | Resolução para redimensionamento |
| Precisão numérica | bf16 | Formato de precisão mista |
| Taxa de aprendizado | 10-4 | Taxa de aprendizado da rede “Transformer” |
| Taxa de aprendizado do codificador de texto | 10-5 | Taxa de aprendizado utilizada nos codificadores de entrada textual |
| Tamanho de lote efetivo | 2 | Amostras acumuladas antes da atualização dos pesos |
| Passos de treinamento | 1000 | Limite de passos para treinamento |
| Agendador da Taxa de Aprendizado | “cosine” | Reduz a taxa de aprendizado ao longo do treinamento |
| Passos de Aquecimento | 150 | Passos para a transição da taxa de aprendizado de 0 até valor máximo |
| “Gradient Checkpointing” | Ativado | Otimização de memória para treinamento em alta resolução |
Fonte: Dados originais da pesquisa
Avaliação quantitativa
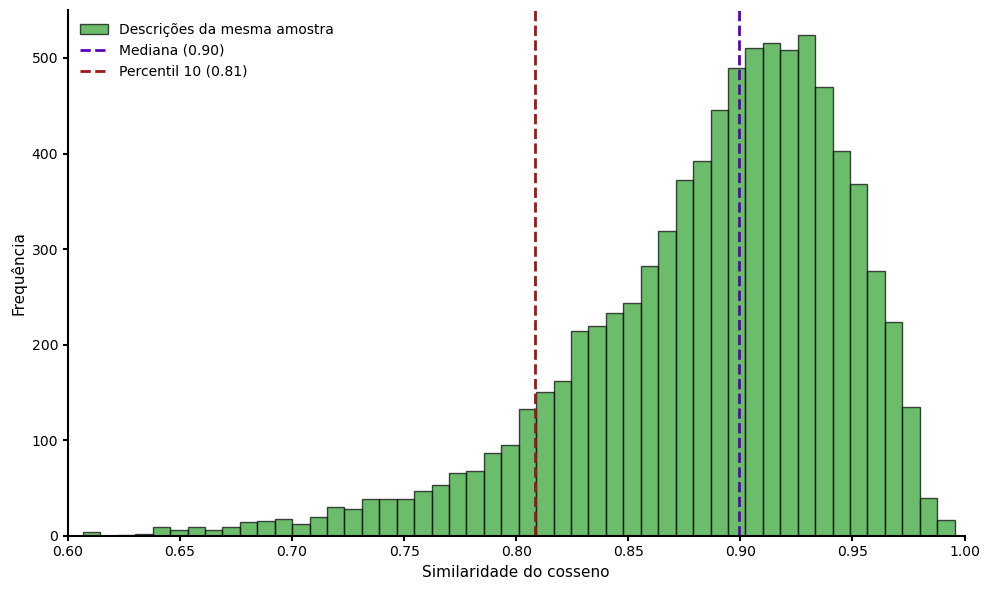
Devido à especificidade do domínio de interfaces de usuário, as métricas comumente utilizadas na avaliação de modelos T2I (como CLIPScore e LPIPS) mostraram-se limitadas (Hessel et al., 2021; Zhang et al., 2018). Adotou-se uma estratégia de avaliação mais compatível com os objetivos do estudo, comparando a instrução textual original com uma descrição textual da imagem, gerada pelo mesmo processo utilizado na construção do conjunto de treinamento. Para isso, utilizou-se a técnica “Sentence-BERT” [SBERT] (Reimers e Gurevych, 2019), que projeta frases inteiras em vetores densos para calcular a similaridade semântica. Para adaptar a métrica ao domínio de UIs, foram estabelecidos limites empíricos mínimos e máximos. O limite máximo empírico (Tmax) foi definido a partir de um experimento de variação, onde 20 legendas distintas foram geradas para 44 imagens de UIs, e a similaridade do SBERT entre todos os pares possíveis de legendas foi computada. O 10° percentil da distribuição estatística dessas pontuações foi adotado como Tmax, conforme ilustrado na Figura 2.
Figura 2. Histograma da distribuição de similaridade (SBERT) para a definição do limite máximo empírico de consistência
Fonte: Dados originais da pesquisa
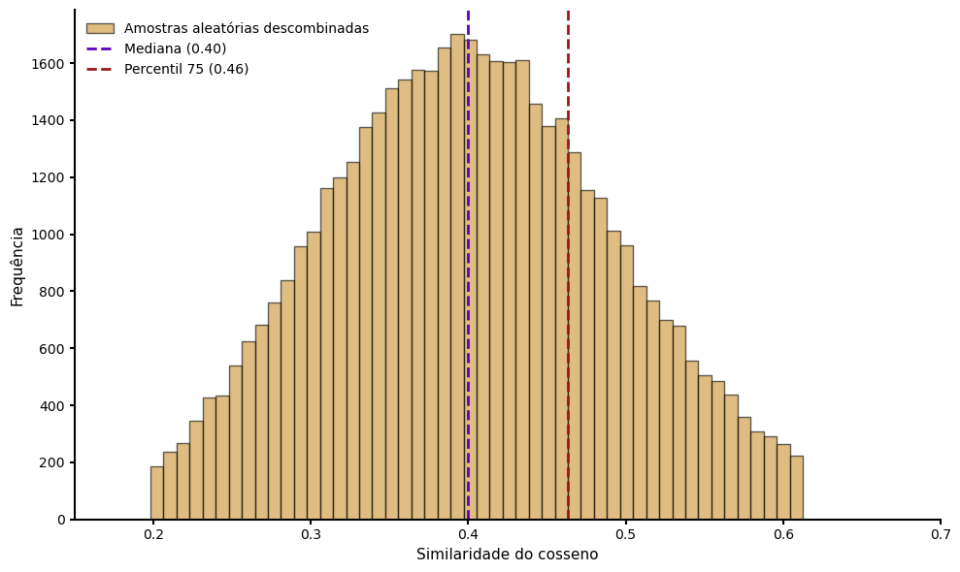
Em contraste, o limite inferior empírico (Tmin) foi estabelecido para definir um nível mínimo de similaridade decorrente do ruído intrínseco ao domínio. Para estimar esse nível, utilizaram-se as legendas do conjunto de dados de treinamento do “ControlNet” para gerar 50.000 pares aleatórios, permitindo calcular a similaridade residual do SBERT entre as descrições das UIs. A Figura 3 ilustra a distribuição estatística obtida, e o 75° percentil foi definido como Tmin.
Figura 3. Histograma da distribuição de similaridade (SBERT) entre pares aleatórios descombinados, utilizado para a definição do limite inferior empírico de similaridade residual
Fonte: Dados originais da pesquisa
A etapa final da calibração consistiu em padronizar os resultados brutos da métrica utilizando a técnica de escalonamento “Min-Max” aliada a um mecanismo de limitação rígida. A Similaridade Semântica Normalizada [SSN] foi calculada por meio da fórmula (1):
SSN = min (1, max (0, (Sobs – Tmin) / (Tmax – Tmin))) (1)
em que: Sobs: é a similaridade de cosseno bruta observada; Tmin: é o limite inferior empírico; e Tmax: é o limite superior empírico. Essa função penaliza amostras ruidosas, zerando o resultado se o valor bruto for menor ou igual ao limite inferior, e atribui a nota máxima se atingir ou superar o teto empírico. Para a fase de avaliação, foi utilizado um subconjunto independente de 44 amostras, separado previamente do conjunto de treinamento. Para cada par de esboço e instrução textual, foram geradas dez imagens utilizando “seeds” fixas, e a similaridade entre a amostra gerada e a respectiva instrução de entrada foi calculada para obter uma estimativa média do desempenho.
Avaliação qualitativa
Além da análise quantitativa, a avaliação por profissionais da área foi realizada para compreender nuances subjetivas. Para tanto, foi elaborado um questionário estruturado, aplicado de forma anônima e online, composto por uma seção de caracterização do perfil dos respondentes e seis blocos de avaliação das amostras. A amostra de conveniência foi composta por 20 profissionais das áreas de “UI/UX design” e desenvolvimento “frontend” com residência no Brasil ou nos Estados Unidos e experiência mínima de três anos na indústria de software. Os participantes foram questionados em relação à qualidade estética, fidelidade estrutural e utilidade prática da ferramenta, utilizando uma escala Likert de cinco pontos para avaliação (Likert, 1932). Para a seleção das amostras submetidas à avaliação qualitativa, utilizou-se a métrica SSN como critério de filtragem. A seleção foi realizada de forma intencional, considerando os resultados obtidos pela métrica e a disponibilidade limitada de recursos humanos. O número reduzido de especialistas e a seleção não aleatória das amostras constituem limitações metodológicas que devem ser consideradas na interpretação dos resultados da avaliação. Essa abordagem qualitativa objetivou validar a percepção de profissionais em um contexto próximo ao uso real, permitindo avaliar o nível de aceitação da aplicação e seu potencial para auxílio no fluxo de trabalho de profissionais das áreas de desenvolvimento de UIs.
3. Resultados e Discussão
A avaliação dos resultados foi conduzida por meio de uma análise quantitativa da similaridade semântica e uma avaliação qualitativa com profissionais da indústria, seguida por um comparativo com modelos de difusão existentes.
Similaridade dos “embeddings” SBERT
A Similaridade Semântica Normalizada (SSN) foi calculada para 440 amostras de interfaces de usuário. A Tabela 3 consolida as métricas globais obtidas neste experimento.
Tabela 3. Análise estatística da similaridade semântica normalizada entre “embeddings”
| Métrica | Valor |
|---|---|
| Média | 0,6181 |
| Desvio padrão | 0,4021 |
| 10° percentil | 0 |
| 25° percentil | 0 |
| Mediana | 0,7928 |
| 75° Percentil | 0,9843 |
| 90° Percentil | 1 |
Fonte: Resultados originais da pesquisa
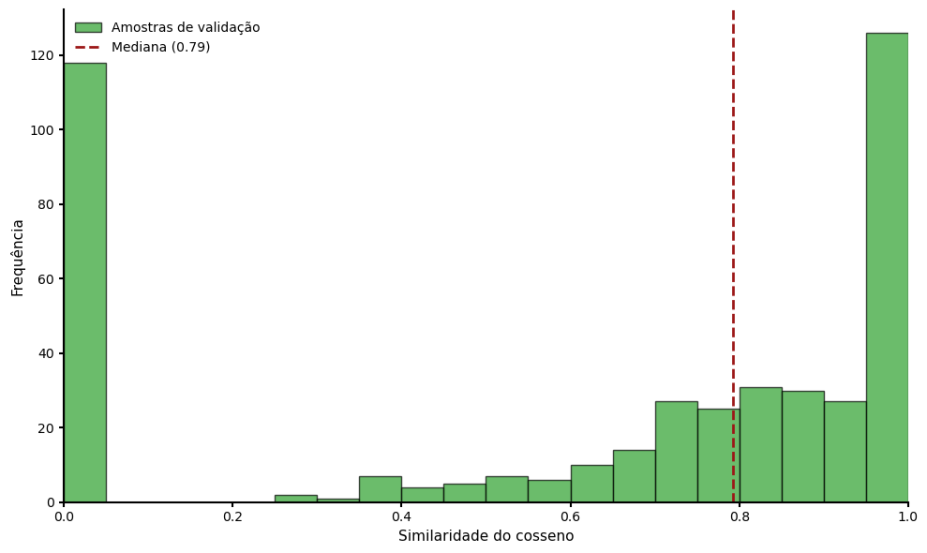
A Figura 4 ilustra a distribuição de frequência dos resultados da SSN.
Figura 4. Distribuição da SSN entre as instruções textuais originais e as descrições extraídas das amostras geradas
Fonte: Resultados originais da pesquisa
A análise quantitativa das 440 amostras de validação indicou que o modelo consegue capturar a intenção da instrução na maioria das vezes, com uma mediana global de 0,7928. No entanto, a média global de 0,6181 e o desvio padrão de 0,4021 destacam a natureza estocástica do processo de geração e a inconsistência entre as UIs geradas, especialmente com diferentes níveis de complexidade. Observou-se que uma mesma entrada pode gerar desempenhos opostos dependendo da “seed” utilizada na inferência.
Os percentis 10 e 25 registraram o valor mínimo de zero, o que, devido ao mecanismo de corte da normalização SSN, indica que pelo menos 25% dos testes de inferência falharam por apresentarem apenas similaridade artificial com as instruções textuais originais. Esse comportamento volátil e polarizado corrobora achados em trabalhos correlatos (Avrahami et al., 2024; Ho et al., 2020; Xu et al., 2023), reforçando a importância de gerar múltiplas imagens e aplicar um filtro rigoroso de aderência semântica antes da avaliação humana. Com base nessa análise, seis amostras de alta fidelidade foram selecionadas manualmente para a avaliação qualitativa.
Avaliação dos profissionais da indústria
A avaliação qualitativa envolveu 20 profissionais (65% desenvolvedores frontend, 35% UI/UX designers), com 70% no Brasil e 30% nos Estados Unidos. A maioria (80%) utiliza IA diariamente, e 85% já aplicaram soluções de IA para geração de mockups ou protótipos de UI. Os participantes avaliaram seis critérios (Q1 a Q6) em uma escala Likert de cinco pontos, agrupados em desempenho satisfatório, pouco satisfatório ou nada satisfatório.
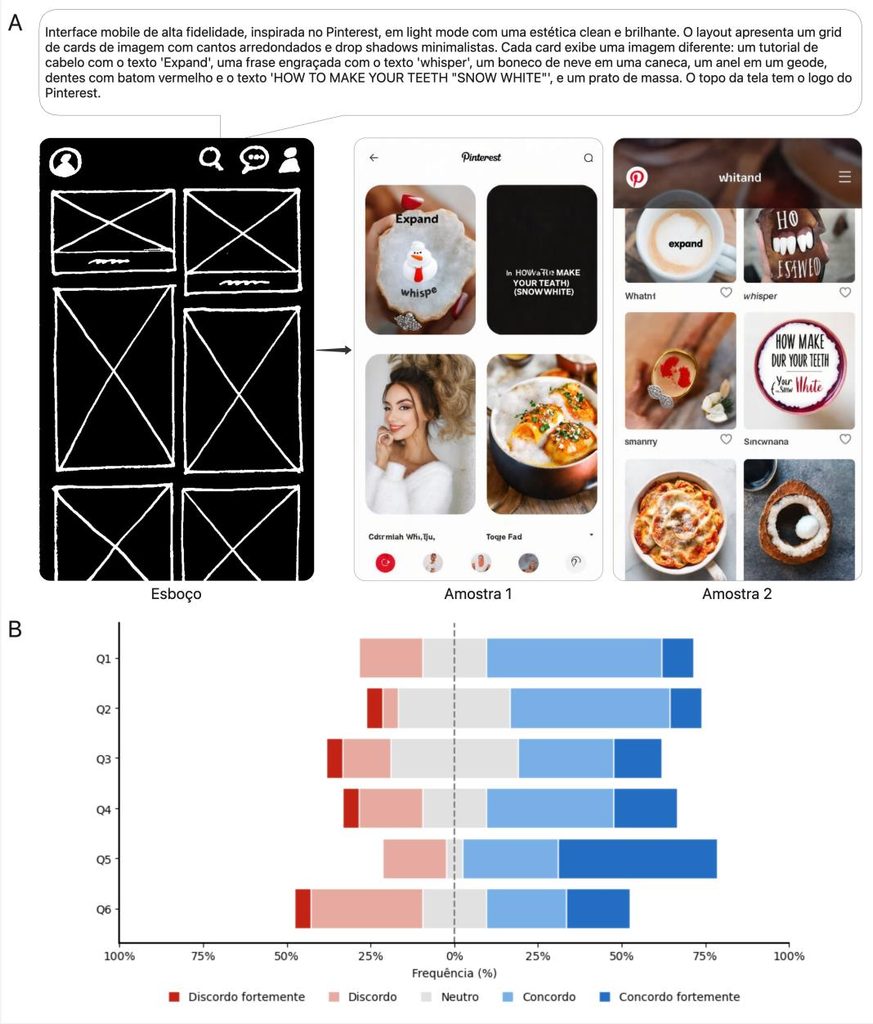
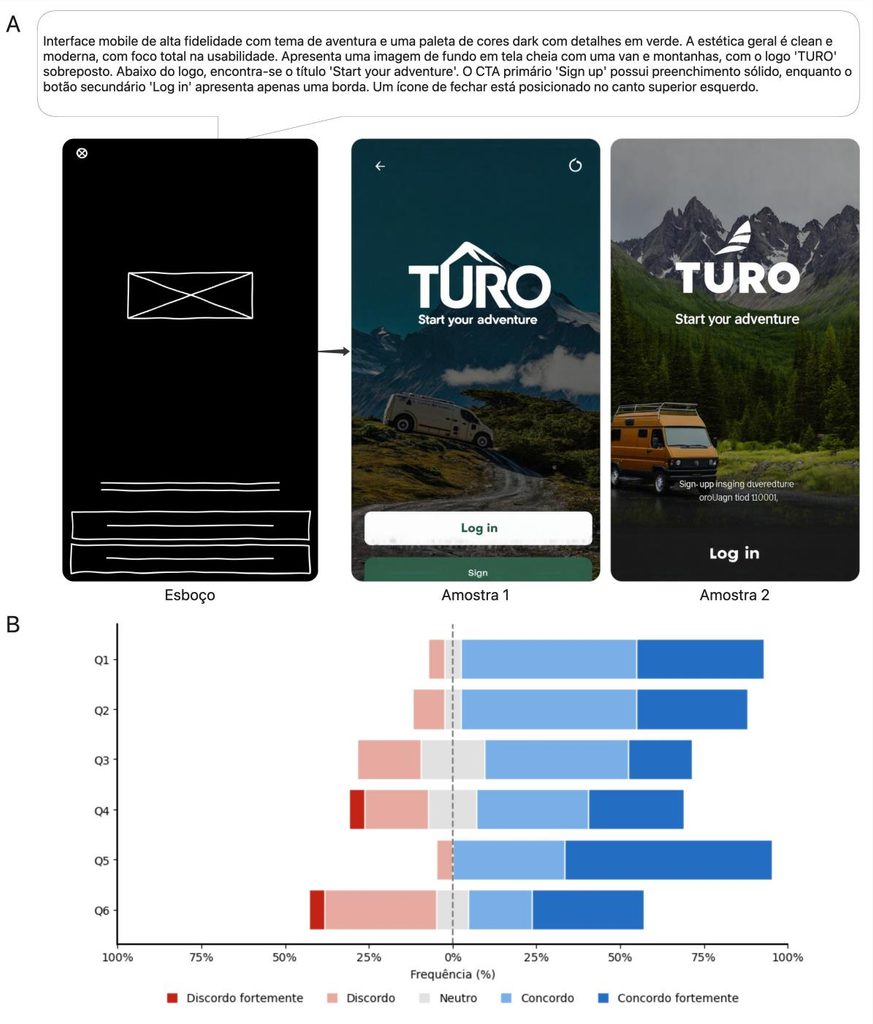
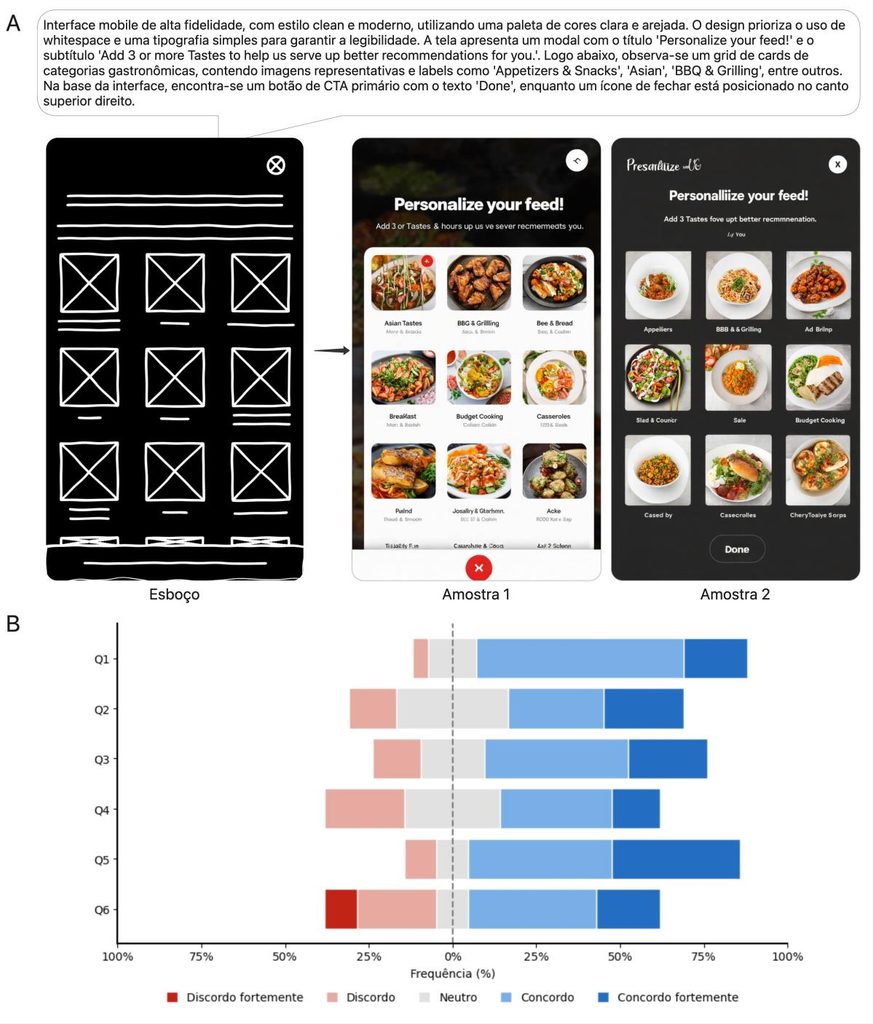
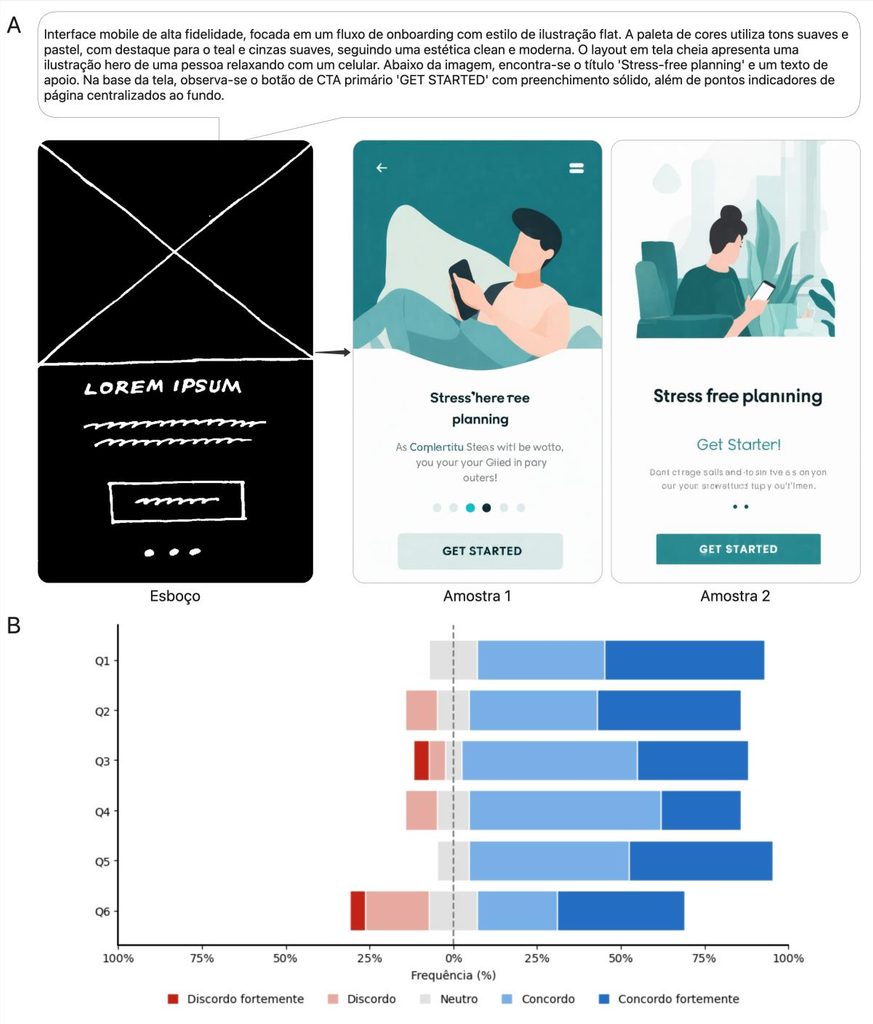
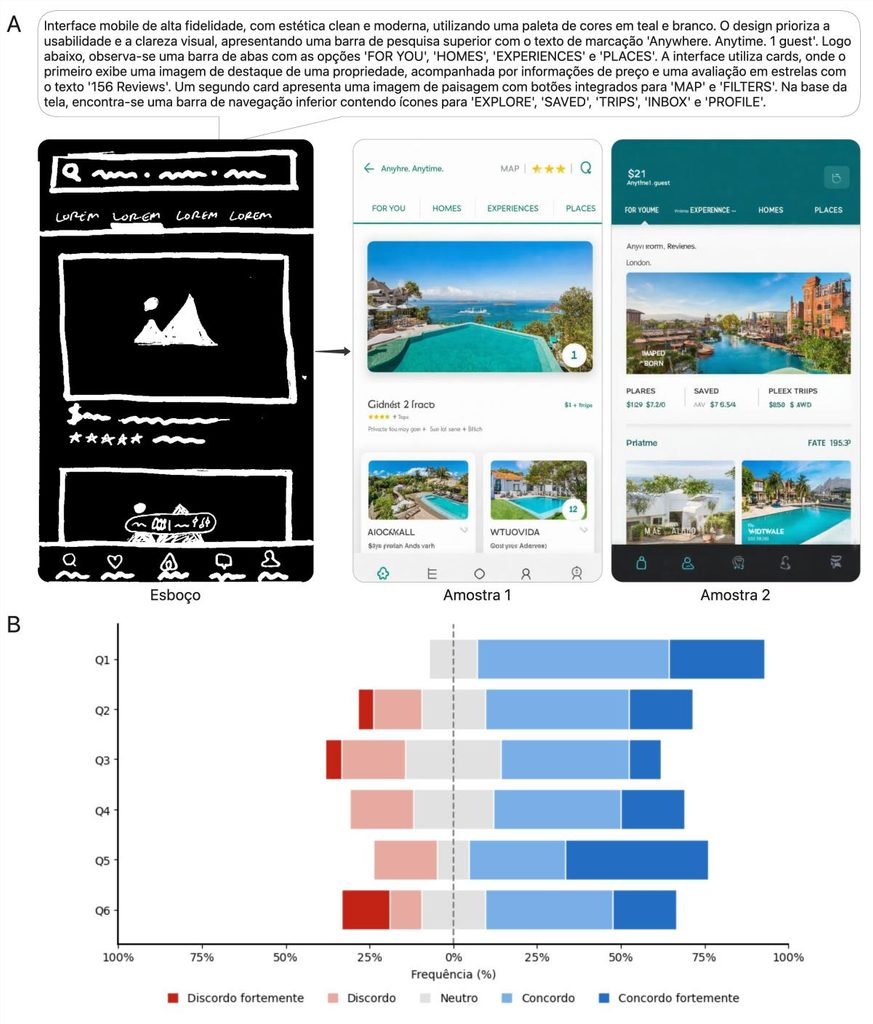
As Figuras 5 a 10 apresentam os resultados da avaliação para as amostras selecionadas.
Figura 5. Resultados da avaliação dos profissionais para a primeira amostra selecionada
Fonte: Resultados originais da pesquisa
Figura 6. Resultados da avaliação dos profissionais para a segunda amostra selecionada
Fonte: Resultados originais da pesquisa
Figura 7. Resultados da avaliação dos profissionais para a terceira amostra selecionada
Fonte: Resultados originais da pesquisa
Figura 8. Resultados da avaliação dos profissionais para a quarta amostra selecionada
Fonte: Resultados originais da pesquisa
Figura 9. Resultados da avaliação dos profissionais para a quinta amostra selecionada
Fonte: Resultados originais da pesquisa
Figura 10. Resultados da avaliação dos profissionais para a sexta amostra selecionada
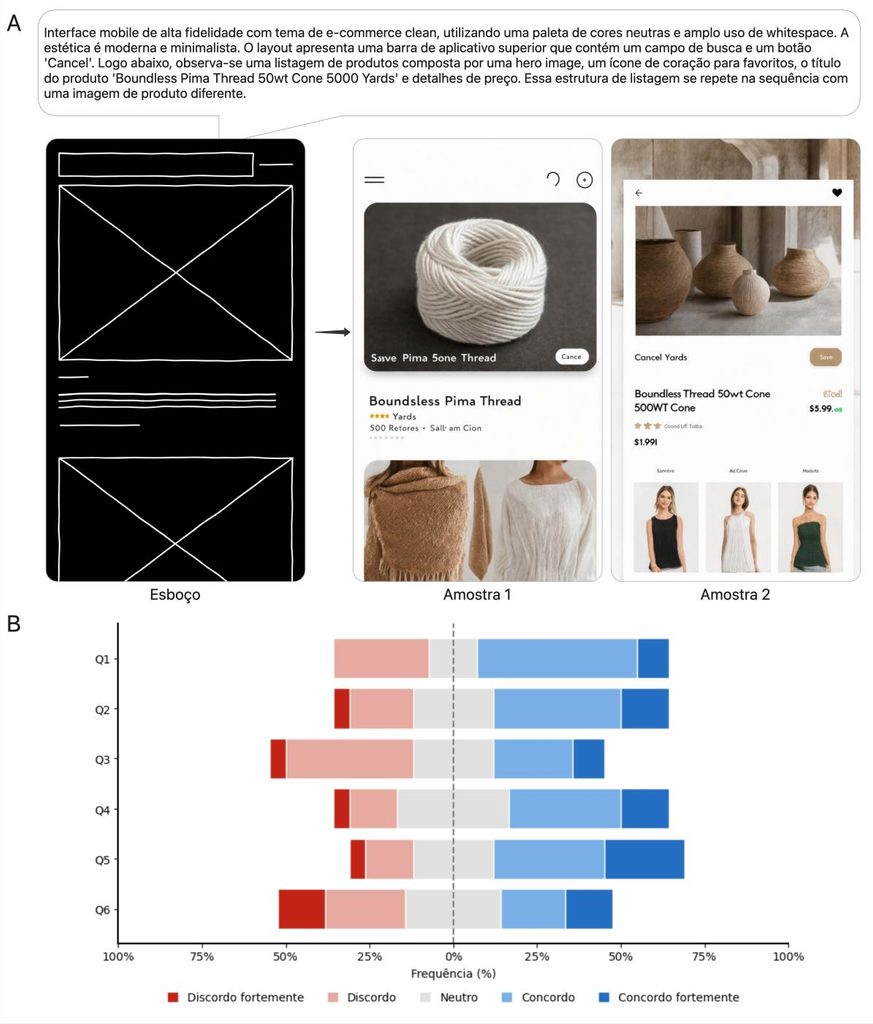
Fonte: Resultados originais da pesquisa
Os dados consolidados para a afirmação Q1 (precisão da UI em refletir o contexto funcional) indicaram que 77% das amostras tiveram desempenho satisfatório. Esse achado sugere que o modelo compreende o contexto funcional das solicitações na maioria dos cenários. No entanto, a amostra da Figura 10 apresentou 28,6% de desaprovação, indicando falhas de compreensão semântica em certas nuances.
A afirmação Q2 (fidelidade estrutural ao esboço original) revelou que interfaces de baixa complexidade, como as telas de login e onboarding (Figuras 6 e 8), alcançaram 85,7% e 81% de aprovação, respectivamente. Isso demonstra que o modelo respeitou os limites do esboço. Em contraste, amostras mais complexas obtiveram entre 52,4% e 61,9% de satisfação, sugerindo que a adequação da estrutura geométrica foi menos eficaz em cenários de maior complexidade.
A viabilidade técnica das UIs geradas (Q5) recebeu uma recepção positiva, com uma aprovação média de 78,6%. Esse resultado indica que o pipeline generativo estabelece uma arquitetura de componentes bem definida e uma organização estrutural lógica, o que pode reduzir o atrito na implementação de código.
Em contrapartida, os critérios Q3 (eficácia da hierarquia visual) e Q4 (qualidade estética geral) apresentaram os maiores índices de reprovação, com 21,4% e 19,8% de avaliações nada satisfatórias, respectivamente. A amostra da Figura 10, por exemplo, teve 42,9% de reprovação para Q3, onde o modelo suprimiu elementos críticos e introduziu artefatos textuais deformados, comprometendo a integridade visual. Essa divergência destaca que, embora a estrutura técnica possa ser satisfatória, os profissionais mantêm alta exigência estética, penalizando tipografias embaralhadas ou omissões estruturais que prejudicam a clareza comunicacional.
A avaliação da qualidade geral (Q6) registrou uma média global de 50,8% de desempenho satisfatório. A segmentação das respostas revelou polarização: engenheiros frontend demonstraram maior tolerância a anomalias visuais (61,9% de aprovação), valorizando a agilidade na estruturação inicial. Já os designers UI/UX apresentaram um índice de rejeição de 50%, com apenas 28,6% de avaliações satisfatórias, indicando maior sensibilidade à perda de fidelidade aos esboços e à degradação estética.
Comparativo com o estado da arte
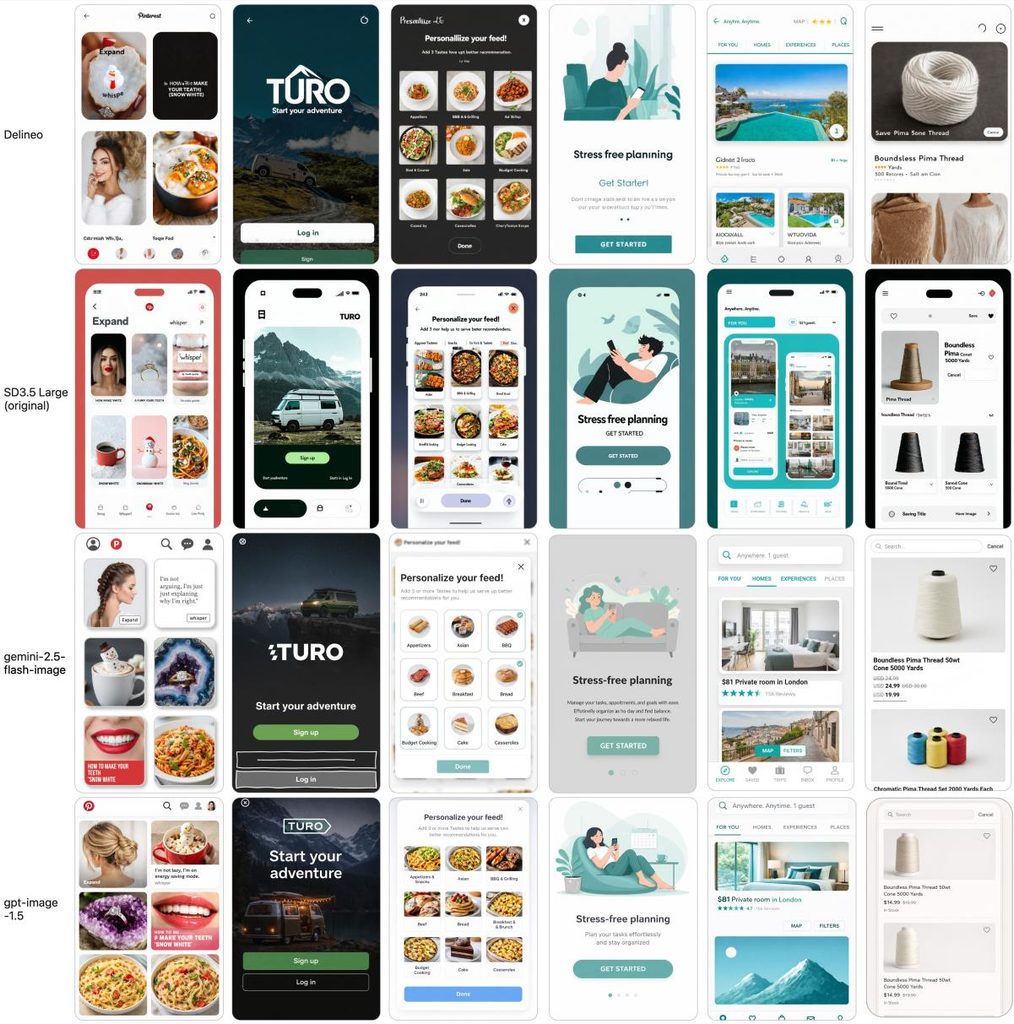
Para comparar o Delineo com modelos multimodais de referência, foram realizados testes de inferência com as mesmas amostras, utilizando o modelo Gemini 2.5-flash-image da Google (2025), o gpt-image-1.5 da OpenAI (2026) e o modelo base original Stable Diffusion 3.5 Large (Rombach et al., 2022). A Figura 11 ilustra esse comparativo.
Figura 11. Comparativo do Delineo contra os modelos mais poderosos da atualidade
Fonte: Resultados originais da pesquisa
O comparativo demonstra que os resultados gerados pelo Delineo superam as capacidades do modelo base original em prototipagem de UI. A capacidade do Delineo para geração da estrutura é equiparável à dos modelos mais poderosos do mercado. Em termos estéticos, o Delineo se mostra mais próximo dos padrões da indústria, com um aspecto mais moderno e profissional do que os resultados dos outros modelos, o que atesta a eficiência do adaptador de baixo posto (LoRA) como parte essencial do pipeline. Os modelos da Google e OpenAI, por outro lado, demonstraram menor esquecimento de elementos solicitados e maior capacidade de raciocínio, conseguindo elaborar conteúdo textual relevante e adicionar elementos não especificados, mas comuns ao contexto semântico da UI.
Os resultados indicam que a adaptação de um modelo de difusão latente condicionada para prototipagem de interface de usuário é tecnicamente viável. O modelo Delineo superou o desempenho do modelo base original, apresentando capacidade de gerar estruturas de UI com fidelidade ao esboço e um nível estético mais alinhado aos padrões da indústria em comparação com outros modelos de difusão. Contudo, a avaliação qualitativa revelou que, embora a arquitetura de componentes seja bem definida e a viabilidade técnica para implementação seja alta, ainda persistem desafios significativos na geração de tipografia precisa e na manutenção da qualidade estética e hierarquia visual em UIs de alta complexidade. A polarização nas percepções dos profissionais, especialmente entre desenvolvedores frontend e designers UI/UX, destaca a necessidade de aprimoramentos arquiteturais para atender ao rigor visual e à usabilidade exigidos pela indústria de desenvolvimento de software.
4. Conclusão
O presente estudo teve como objetivo adaptar modelos de difusão latente para a geração de protótipos de alta fidelidade, utilizando treinamento suplementar e recursos de código aberto. Verificou-se, por meio de avaliação quantitativa, que o modelo Delineo conseguiu capturar a intenção das instruções textuais na maioria das amostras, embora tenha demonstrado inconsistência e falhas na similaridade semântica em cenários de maior complexidade. A avaliação qualitativa com especialistas da indústria confirmou a viabilidade técnica da abordagem e a capacidade do modelo em gerar estruturas de interface de usuário com fidelidade ao esboço original para layouts mais simples. Observou-se que o Delineo superou o desempenho do modelo base original e apresentou um nível estético mais alinhado aos padrões da indústria em comparação com outros modelos de difusão, estabelecendo uma arquitetura de componentes bem definida que pode otimizar a transição entre requisitos visuais e a implementação de código.
Contudo, a pesquisa evidenciou desafios significativos, como a degradação estética, a perda de elementos funcionais na estruturação lógica da interface e a dificuldade na geração de tipografia precisa, especialmente em interfaces de alta complexidade. A natureza estocástica do processo de geração e a polarização nas percepções dos profissionais, com designers UI/UX demonstrando maior sensibilidade às falhas visuais, destacaram a necessidade de aprimoramentos. As limitações do estudo incluíram o grupo reduzido de especialistas na avaliação qualitativa e a escassez de bancos de dados públicos diversificados. Sugere-se que estudos futuros se concentrem em aprimoramentos arquiteturais para elevar o rigor visual e a usabilidade, além de explorar técnicas que demandem menor volume de dados para o treinamento de novos modelos generativos, visando equilibrar a agilidade técnica com a excelência estética exigida pela indústria de desenvolvimento de software.
Referências Bibliográficas
Al-Saqqa, S.; Sawalha, S.; Abdel-Nabi, H. 2020. Agile software development: methodologies and trends. International Journal of Interactive Mobile Technologies 14(11): 246.
Avrahami, O.; Hertz, A.; Vinker, Y.; Arar, M.; Fruchter, S.; Fried, O.; Cohen-Or, D.; Lischinski, D. 2024. The chosen one: consistent characters in text-to-image diffusion models. In: Proceedings of SIGGRAPH ’24: Special Interest Group on Computer Graphics and Interactive Techniques Conference, 2024, Denver, CO, EUA. Anais… p. 1-12.
Beltramelli, T. 2018. Pix2code: generating code from a graphical user interface screenshot. In: Proceedings of the EICS ’18: ACM Symposium on Engineering Interactive Computing Systems, 2018, Paris, França. Anais… p. 1-6.
Bradski, G. 2000. The opencv library. Dr. Dobb’s Journal: Software Tools for the Professional Programmer 25(11): 120-123.
Bunian, S.; Li, K.; Jemmali, C.; Harteveld, C.; Fu, Y. El-Nasr, M.S. 2021. VINS: visual search for mobile user interface design. In: Proceedings of the Conference on Human Factors in Computing Systems, 2021, Yokohama, Japão. Anais… p. 1-14.
Couairon, G.; Careil, M.; Cord, M.; Lathuilière, S.; Verbeek, J. 2023. Zero-shot spatial layout conditioning for text-to-image diffusion models. In: Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023, Paris, França. Anais… p. 1274-2183.
Deka, B.; Huang, Z.; Franzen, C.; Hibschman, J.; Afergan, D.; Li, Y.; Nichols, J.; Kumar, R. 2017. Rico: a mobile app dataset for building data-driven design applications. In: UIST ’17: Proceedings of the 30th Annual ACM Symposium on User Interface Software and Technology, 2017, Québec, Canadá. Anais… p. 845-854.
Esser, P.; Kulal, S.; Blattmann, A.; Entezari, R.; Müller, J.; Saini, H.; Levi, Y.; Lorenz, D.; Sauer, A.; Boesel, F.; Podell, D.; Dockhorn, T.; English, Z.; Lacey, Z.; Goodwin, A.; Marek, Y.; Rombach, R. 2024. Scaling rectified flow transformers for high-resolution image synthesis. In: Proceedings of the International Conference on Machine Learning, 2024, Vienna, Austria. Anais… p. 12606-12633.
Feng, S.; Ma, S.; Wang, H.; Kong, D.; Chen, C. 2024. MUD: towards a large-scale and noise-filtered UI dataset for modern style UI Modeling. In: Proceedings of the CHI Conference on Human Factors in Computing Systems, 2024, Honolulu, HI, EUA. Anais… p. 1-14.
Gandikota, R.; Materzyńska, J.; Zhou, T.; Torralba, A.; Bau, D. 2025. Concept Sliders: LoRA Adaptors for Precise Control in Diffusion Models. p. 172-188. In: Leonardis, A.; Ricci, E.; Roth, S.; Russakovsky, O.; Sattler, T.; Varol, G. Computer Vision – ECCV 2024: Lecture Notes in Computer Science. v.15098. Springer, Cham, Suiça.
Google. 2025. Gemini models. Disponível em https://ai.google.dev/gemini-api/docs/models. Acesso em 08 abr. 2026.
Gugger, S.; Debut, L.; Wolf, T.; Schmid, P.; Mueller, Z.; Mangrulkar, S.; Sun, M.; Bossan, B. 2022. Accelerate: training on any device with PyTorch. Disponível em https://github.com/huggingface/accelerate. Acesso em 07 fev. 2026.
He, J.; Treude, C.; Lo, D. 2025. LLM-based multi-agent systems for software engineering: literature review, vision, and the road ahead. ACM Transactions of Software Engineering and Methodology 34(5): 164-193.
Hessel, J.; Holtzman, A.; Forbes, M.; Bras, R. L.; Choi, Y. 2021. ClipScore: a reference-free evaluation metric for image captioning. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing, 2021, Punta Cana, República Dominicana, Anais… p. 7514-7528.
Ho, J.; Jain, A.; Abbeel, P. 2020. Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 1(33): 6840-6851.
Hu, E. J.; Shen, Y.; Wallis, P.; Allen-Zhu, Z.; Li, Y.; Wang, S.; Wang, L.; Chen, W. 2022. Lora: low-rank adaptation of large language models. In: Proceedings of the International Conference on Learning Representations, 2022, virtual. Anais… p. 1-26.
Huang, F.; Canny, J. F.; Nichols, J. 2019. Swire: sketch-based user interface retrieval. In: Proceedings of the CHI Conference on Human Factors in Computing Systems, 2019, Glasgow, Escócia. Anais… p. 1-10.
Ismail, A.A.; Hassan, R. 2019. Technical competencies in digital technology towards industrial revolution 4.0. Journal of Technical Education and Training 11(3): 55-62.
Lauff, C. A.; Kotys-Schwartz, D.; Rentschler, M. E. 2018. What is a prototype? What are the roles of prototypes in companies?. Journal of Mechanical Design 140(6): 061102.
Likert, R. 1932. A technique for the measurement of attitudes. Archives of Psychology 22(140): 1-55.
Liu, V.; Chilton, L. B. 2022. Design guidelines for prompt engineering text-to-image generative models. In: Proceedings of the CHI Conference on Human Factors in Computing Systems, 2022, New Orleans, LA, EUA. Anais… p. 1-23.
Mou, C.; Wang, X.; Xie, L.; Wu, Y.; Zhang, J.; Qi, Z.; Shan, Y. 2024. T2i-adapter: learning adapters to dig out more controllable ability for text-to-image diffusion models. In: Proceedings of the AAAI Conference on Artificial Intelligence 38(5): 4296-4304.
OpenAI. 2026. Image generation. Disponível em https://developers.openai.com/api/docs/models/gpt-image-1.5. Acesso em 08 abr. 2026.
Paszke, A.; Gross, S.; Massa, F.; Lerer, A.; Bradbury, J.; Chanan, G.; Killeen. T.; Lin, Z.; Gimelshein, N.; Antiga, L.; Desmaison, A.; Köpf, A.; Yang, E.; DeVito, Z.; Raison, M.; Tejani, A.; Chilamkurthy, S.; Steiner, B.; Fang, L.; Bai, J.; Chintala, S. 2019. PyTorch: an imperative style, high-performance deep learning library. Advances in Neural Information Processing Systems 32: 8024-8035.
Radford, A.; Kim, J.W.; Hallacy, C.; Ramesh, A.; Goh, G.; Agarwal, S.; Sastry, G.; Askell, A.; Mishkin, P.; Clark, J.; Krueger, G.; Sutskever, I. 2021. Learning transferable visual models from natural language supervision. In: Proceedings of the International Conference on Machine Learning, 2021, virtual. Anais… 8748-8763.
Raffel, C.; Shazeer, N.; Roberts, A.; Lee, K.; Narang, S.; Matena, M.; Zhou, Y.; Li, W.; Liu, P.J. 2020. Exploring the Limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research 21(140): 1-67.
Reimers, N.; Gurevych, I. 2019. Sentence-bert: sentence embeddings using siamese bert-networks. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing, 2019, Hong Kong, China. Anais… 3982-3992.
Rombach, R.; Blattmann, A.; Lorenz, D.; Esser, P.; Ommer, B. 2022. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, New Orleans, LA, EUA. Anais… p. 10684-10695.
Stanford Institute for Human-Centered AI [HAI]. 2025. The AI Index 2025 annual report. Disponível em https://hai.stanford.edu/assets/files/hai_ai_index_report_2025.pdf. Acesso em 24 out. 2025.
von Platen, P.; Patil, S.; Lozhkov, A.; Cuenca, P.; Lambert, N.; Rasul, K.; Davaadorj, M.; Wolf, T. 2022. Diffusers: state-of-the-art diffusion models. Disponível em https://github.com/huggingface/diffusers. Acesso em 07 fev. 2026.
Wan, Y.; Wang, C.; Dong, Y.; Wang, W.; Li, S.; Huo, Y.; Lyu, M. 2025. Divide-and-conquer: generating UI code from screenshots. Proceedings of the ACM on Software Engineering 2(FSE): 2099-2122.
Wang, J.; Huang, Y.; Chen, C.; Liu, Z.; Wang, S.; Wang, Q. 2024. Software testing with large language models: survey, landscape, and vision. IEEE Transactions on Software Engineering 50(4): 911-936.
Wolf, T.; Debut, L.; Sanh, V.; Chaumond, J.; Delangue, C.; Moi, A.; Cistac, P.; Rault, T.; Louf, R.; Funtowicz, M.; Davison, J.; Shleifer, S.; von Platen, P.; Ma, C.; Jernite, Y.; Plu, J.; Xu, C.; Le Scao, T.; Gugger, S.; Drame, M.; Lhoest, Q.; Rush, A. M. 2020. Transformers: state-of-the-art natural language processing. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing: System Demonstration: 38-45.
Wu, X.; Huang, S.; Wei, F. 2024. Mixture of LoRA experts. In: Proceedings of the International Conference on Learning Representations, 2024, Vienna, Austria. Anais… p. 1-17.
Xu, S.; Ma, Z.; Huang, Y.; Lee, H.; Chai, J. 2023. Cyclenet: rethinking cycle consistency in text-guided diffusion for image manipulation. Advances in Neural Information Processing Systems, 1(36), 10359-10384.
Zhang, L.; Rao, A.; Agrawala, M. 2023. Adding conditional control to text-to-image diffusion models. In: Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023, Paris, França. Anais… p. 3836-3847.
Zhang, R.; Isola, P.; Efros, A. A.; Shechtman, E.; Wang, O. 2018. The unreasonable effectiveness of deep features as a perceptual metric. In: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2018, San Francisco, CA, EUA. Anais… p. 586-595.
Zhao, S.; Chen, D.; Chen, Y.; Bao, J.; Hao, S.; Yuan, L.; Wong, K. 2023. Uni-ControlNet: all-in-one control to text-to-image diffusion models. Proceedings of the International Conference on Neural Information Processing Systems, 2023, New Orleans, LA, EUA. Anais… p. 11127-11150.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy